
经典监督学习模型:线性模型、决策树与支持向量机
线性模型、决策树和支持向量机是经典监督学习中三条非常不同的建模路线。它们分别通过线性组合、递归划分和最大间隔来刻画输入与输出之间的关系。
把三章放在一起学习,更容易看清模型结构、优化目标、非线性能力和泛化方式之间的差异。
统一比较框架
| 模型 | 基本表示 | 非线性来源 | 主要优点 | 常见限制 |
|---|---|---|---|---|
| 线性模型 | 特征的加权组合 | 特征变换或广义线性连接函数 | 简洁、可解释、训练高效 | 原始特征空间中表达能力有限 |
| 决策树 | 一系列属性划分规则 | 递归分区天然形成非线性边界 | 规则直观、能处理混合特征 | 容易过拟合,对数据扰动敏感 |
| 支持向量机 | 最大间隔超平面 | 核函数映射到高维空间 | 小样本、高维任务中表现稳定 | 大规模训练成本高,参数和核选择重要 |
三种模型都可以完成监督学习任务,但它们引入先验偏好的方式不同,因此适用的数据结构也不同。
线性模型:从回归到分类
线性模型用特征的加权组合表达预测函数,是理解最小二乘、对数几率回归和许多复杂模型的基础。
所需数学知识
- 求偏导
- 矩阵求导
- 求逆矩阵
名词解释
1.序关系
有序:属性之间可进行相对比较(如大、中、小)无序:属性之间不可进行相对比较(如南瓜、西瓜、冬瓜)2.符号arg与s.t.
arg:即argument(参数),用于表示求出指定函数时的**参数取值** 例如: arg min 就是使后面这个式子达到最小值时的 变量的取值 arg max 就是使后面这个式子达到最大值时的 变量的取值
s.t.:即subject to,意思是受限于...,后面紧跟约束条件3.闭式解
也叫做 解析解,闭式解就是一些严格的公式,给出任意的自变量就可以求出其因变量,也就是问题的解南瓜书中说闭式解是指可以通过具体的表达式解出待解参数模型介绍
表示形式
对于拥有 个属性的样本,特征向量可写为:
其中 表示第 个属性的属性值。各属性的线性组合作为预测函数:
向量形式为:
其中 和 均为列向量, 中的元素表示不同属性的权重 故线性模型具有很强的可解释性
模型优点
- 简单(模型表示、数学公式简单)
- 基本(通过引入层级结构或高维映射可以得到许多非线性模型)
- 可理解性好(通过权重可以看出对属性的偏好)
属性数值化
总结:离散属性的处理:若有“序”(order),则连续化;否则,转化为 𝑘维向量
对于线性模型的求解,我们首先需要明确参数的输入和求解两个部分
我们知道模型的输入为各个示例 ,其中的由d个属性组成, 而我们用d个属性值表示一个具体的示例作为输入
这时我们会发现我们需要注意属性值的数据类型 于是这里我们把属性分为两类
-
连续属性
-
离散属性
- 有序的离散属性
- 无序的离散属性
对于有序的属性,我们用相对值表示属性值,如大、中、小分别用1,0.5,0来表示
对于无序的属性,我们用0/1表示属性值,我们记改属性有m种属性值,则一个属性值需要m维列向量进行表示。
比如属性“瓜的类别”有西瓜、南瓜、冬瓜三种取值,可分别进行独热编码:
、、 分别表示西瓜、南瓜、冬瓜。
对于回归,二分类,多分类任务,我们给出不同的线性模型

回归任务
最小二乘法
在第二章中我们知道,均方误差是回归任务常见的性能度量。
最小二乘把残差向量的平方欧氏范数作为优化目标,因而具有清晰的几何意义。
定义:通过最小化预测值与真实标记之间的平方残差来求解模型。普通最小二乘最小化的是纵向残差平方和,并不是样本点到直线的垂直欧氏距离。
数学知识:涉及求偏导数
1. 一元线性回归
1. 假设方程
希望预测值 尽可能接近真实标记 。
2. 最小化平方误差
定义平方误差和:
于是最小二乘估计为:
若把目标函数写成均方误差 ,只会多出常数因子 ,不会改变最优解。
3. 对 与 求偏导
是关于 和 的凸二次函数,因此令梯度为零即可得到全局最优解;若所有 都相同,则斜率不能被唯一确定。
4. 求得闭式解
当 时:
其中 ,。
2. 多元线性回归
额外数学知识:矩阵求导与矩阵求逆。
基于本人数学系所教授的高等代数中无此内容,故认为需要额外补充学习。
详见《机器学习》附录 P400 的 A.2 导数。
1. 假设方程
同样希望预测值 尽可能接近真实标记 。
2. 构造增广向量与设计矩阵
定义增广参数和增广样本:
将所有样本按行排列,得到设计矩阵:
标记向量写作 ,平方误差和为:

[图片源于周志华老师]3. 求解参数向量
对目标函数求梯度:
若 满列秩,则 正定且可逆。令梯度为零,得到唯一闭式解:
若 不可逆,最小二乘解可能不唯一,此时可用 Moore–Penrose 伪逆得到一个最小范数解:
也可以加入正则化项表达归纳偏好,详见 6.4 节和 11.4 节。
常见正则化方法包括岭回归(Ridge Regression)、Lasso 和弹性网(Elastic Net)。
4. 得到预测模型
对于增广输入 ,预测值为:
PS:把最小二乘目标写成二次型并使用矩阵求导很有意思,详细推导可参考《南瓜书》P35–P36。
3.广义线性模型(GLM)
通过联系函数,让输出的条件均值与线性预测子建立关系。
对数线性模型
当输出变量为正,且条件均值随输入呈指数尺度变化时,可以使用对数联系函数建模。
个人理解:
其实就是我们在原样本中,通过数值或者散点图,观察到输出标记在指数尺度上变化,故很难直接用一条直线拟合输出标记,因为标记值本身为非线性增长。
而对在指数尺度上变化的输出标记取对数后, 就可以将输出标记映射到线性尺度上变化,故易于用直线拟合
将输出的条件均值记为 。对数线性模型使用对数联系函数:
因此原始尺度上的预测为:
这里的对数函数把输出均值与线性预测子联系起来。偏置 也位于指数内部。
但实质上已是在求取输入空间到输出空间的非线性函数映射
广义线性模型通过选择联系函数和响应变量分布来扩展线性模型。联系函数并不是为了把每个观测值强行“变成线性”,而是规定条件均值 与线性预测子之间的关系。
实际建模时,应根据响应变量的取值范围、分布假设和任务目标选择合适的联系函数,再通过极大似然等方法估计模型参数。
而由此我们引出了广义线性模型(Generalized Linear Model)的定义:
其中 称为联系函数(link function),它把输出分布的条件均值与线性预测子联系起来。
广义线性模型的参数估计常通过加权最小二乘法或极大似然法进行
对数线性模型是广义线性模型在 时的一个特例。 显然,一元线性回归也是如此
分类任务
引导
在先前的文章:西瓜书-第3章-线性模型 (Part 1) 中 我们介绍了
一元线性回归、多元线性回归、广义线性回归(对数线性回归)的模型,
用于解决回归类问题
那么对于分类问题,我们又该使用哪种模型呢? 我们知道分类问题可以分成二分类与多分类问题
此处我们先介绍二分类问题所使用的模型
我们可以沿用广义线性模型的思想,用联系函数把类别概率与线性预测子联系起来。模型先输出连续的概率,再根据阈值或决策规则得到离散类别。
对数几率回归
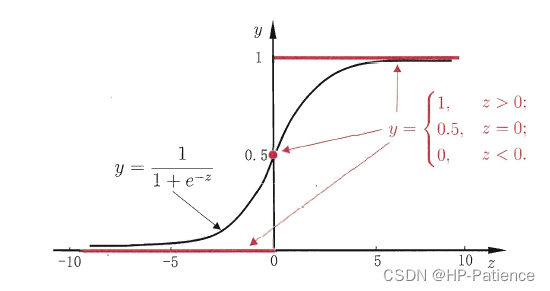
这里我们先给出“单位阶跃函数“(unit-step function)
此函数能够将输出范围在R上的标记 转换为离散值
若预测值大于零就判为正例,小于零则判为反例,预测值为临界值零则可 任意判别
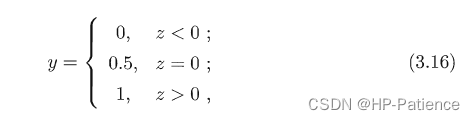
所以我们引入 Sigmoid 函数。令
则样本属于正类的条件概率为:
它对应的对数几率为:
若把 视为样本属于正类的概率,则 是属于负类的概率。二者之比称为几率(odds),几率的对数称为对数几率(log odds)。
最小二乘是一种损失准则,并不是只适用于凸函数的优化算法。在线性回归中,它恰好形成凸二次目标并可在满秩条件下得到闭式解。
对数几率回归通常使用极大似然估计,其负对数似然是凸函数,可通过梯度下降、牛顿法等数值方法求解。
决策树:用属性划分构造规则
决策树通过递归选择属性划分数据。信息增益、增益率和基尼指数决定如何分裂,剪枝则用于控制过拟合。
递归终止条件
决策树使用递归实现,而递归终止条件有以下三种:
- 当前结点所有样本属于同类,无需划分
- 当前属性集为空,无法划分,选取此节点中数量更多的标记作为类别标记
- 当前样本集为空,不能划分,依据父节点中数量更多的标记作为类别标记
名词概念
1.纯度:同类聚集程度高、不同类越分散,则纯度越高 2.信息熵:纯度的量化指标,来源于信息论 3.剪枝:防止决策树过拟合,减去部分划分属性。分为预剪枝和后剪枝
信息熵
信息熵计算公式:
信息熵用于衡量信息的不确定性或信息的混乱程度,我们可以将其用于量化纯度 信息熵越大,数据分布越均匀、随机、杂乱无章,明显这不是我们想要的。 我们想要的是相同类靠近,不同类远离的效果,即需要越小的信息熵
表示选到k类别的概率,而 则表示信息量
我们可以理解对于某一事件,其发生的概率越小,那么其信息量越大;发生的概率越大,那么其信息量越小。所有对两者求期望即得到信息熵。注意: 表示类别集合中的类别数量,例如二分类任务中 。
划分选择
决策树中最重要的部分,用于选择最佳划分属性
1.信息增益(Information Gain)
计算某属性的信息增益,用根节点的信息熵-属性各个属性值的信息熵的加权平均值 信息增益越大,意味着使用属性a进行划分获得的纯度提升越大
2.增益率(Gain Ratio)
由于信息增益对于取值数目较多的属性有所偏好,所以引进增益率进行选择最优划分属性,比如著名的C4.5决策树算法
属性的取值越分散,固有值 通常越大。增益率用信息增益除以固有值,从而抑制信息增益对多取值属性的偏好:
不过,增益率可能偏好固有值很小的属性。C4.5 通常先保留信息增益高于平均水平的候选属性,再从中选择增益率最大的属性。
思考🤔:
增益率可以减少 信息增益对于属性值较多的属性有所偏好 的问题, 但是同样的,增益率对于属性值较少的属性有所偏好 所以实际处理时,对于不同的属性的划分选择可以采取不同的方法,但是在同一层属性划分选择时只能使用同一种方法。
3.基尼指数(Gini Index)
含义:反映从数据集中随机抽取两个样本,其类别标记不一致的概率
CART 分类树常用基尼指数选择划分;CART 回归树通常使用平方误差等回归损失,而不是下面的分类基尼公式。
基尼指数越小,则数据集纯度越高。
剪枝(Pruning)
为了防止决策树模型过拟合而采取的手段 分为预剪枝与后剪枝两种方法
PS:需要先选定 评估方法和性能度量(第二章知识内容) 下列假设使用留出法,以精度为性能度量
预剪枝(Prepruning)
运用贪心思想,可能有弊端
在建立决策树的过程中进行剪枝,使用验证数据比较当前精度与增加划分属性后的精度, 判断是否需要增加划分属性
后剪枝 (Postpruning)
在决策树建立完成后进行剪枝,使用验证数据比较当前精度与把该结点变成叶节点后的精度, 判断是否需要剪去不要的树枝 优点:欠拟合风险小,泛化性能较好
支持向量机:最大间隔与核方法
支持向量机从几何间隔出发,通过对偶问题与核函数处理高维非线性任务,并可扩展到支持向量回归。
章节介绍
统计学领域名声赫赫的SVM与核方法是时至今日仍在高频使用的经典算法。
笔记介绍
对本章各节知识点进行汇总,主要分为引入原因,原理思想,和一些思考,对于数学推导内容介绍较少,有需要的可以先阅读西瓜书,再参考南瓜书的数学推导。
数学知识
大部分都是规划类、最优化的问题,最好先进行相关知识的学习。
这里推荐一本书:最优化:建模、算法与理论 (刘浩洋 户将 李勇锋 文再文)
SVM-支持向量机
引入原因:
在线性可分的条件下,我们在训练集做分类任务时,最基本的想法就是在样本空间中找到一个超平面进行划分, 但是对于分类任务,我们可以画出很多个超平面,这时候就需要引入损失函数,对超平面进行选择,而使得两个异类支持向量的距离最大化,就是我们所说的支持向量机的基本型。

数学公式及其原理:
仍用线性模型表示分类超平面:
点 到该超平面的几何距离为:
令类别标记 ,并采用规范化约束
两条间隔边界 之间的距离为:

最大化间隔等价于最小化 ,因此硬间隔 SVM 的基本形式为:

求解方法:
涉及到二次规划问题,使用拉格朗日乘子法解决问题,我们会得到基本型的“对偶问题”
具体方法不做详解,此处仅做大概阐述:
- 为每条不等式约束引入拉格朗日乘子 。
- 令拉格朗日函数对 和 的偏导为零,消去原始变量。
- 得到关于 的对偶二次规划问题,同时保留 与 等约束。
- 可使用二次规划算法或 SMO 求解 ,再恢复 与 。因此对偶问题并不是普通的无约束优化。
核函数
引入原因:
由于前面的讨论都是基于训练集是线性可分的假设 对于原始空间中线性不可分的数据,可以通过核函数隐式计算高维特征空间中的内积,从而学习非线性决策边界。映射后也不保证数据一定完全线性可分,因此仍可能需要软间隔。
升维思想:
通过特征映射把数据表示到新的空间,并使用核函数直接计算映射后样本的内积;这样可以得到原始空间中的非线性决策边界。
常用核函数:
下面给出常用核函数:

软间隔和正则化:
引入原因:
前面的硬间隔模型假设训练样本线性可分。实际数据可能包含噪声、类别重叠和异常点,即使使用核函数,也不应要求所有样本都被绝对正确地分开,否则模型可能过拟合。
所以我们引入了软间隔(soft margin),即允许部分样本违反间隔约束或被错误分类。 而相应的,先前我们让所有样本正确分类就叫做硬间隔。
正则化思想:
其实软间隔也就是一种正则化,通过对不希望的到的结果进行惩罚,使得优化过程趋向于希望目标。
支持向量回归
引入原因:
我们一开始引入SVM就是为了解决分类问题,而对于回归问题是否也能通过SVM解决呢?🤔
为了解决回归问题,我们引入了支持向量回归,简称SVR(Support Vector Regression)
方法思想:
在损失函数方面,与传统的回归模型用预测和标记的差别计算损失不同,
SVR 使用 -不敏感损失:当预测误差满足 时不产生损失。几何上,这对应预测函数上下各宽 、总宽 的容忍带。
如何选择模型
- 特征数量适中、强调可解释性或需要快速建立基线时,优先考虑线性模型。
- 数据中存在清晰的条件规则、特征尺度差异较大或需要直观解释时,可以尝试决策树及其集成方法。
- 样本量不大但特征维度较高、类别间隔较明显时,支持向量机通常值得尝试。
无论选择哪一种模型,都应回到第二章的评估方法:使用独立验证过程、合适的性能度量和一致的实验设置进行比较。
三类模型的共同点
它们都在特定假设空间中寻找经验风险较小、同时具有一定泛化能力的函数。线性模型依赖参数约束,决策树依赖划分与剪枝,支持向量机依赖最大间隔与正则化。差异最终都可以理解为不同的归纳偏好。
总结
线性模型提供简洁基线,决策树提供可读规则,支持向量机提供最大间隔与核技巧。理解三者的表示方式和约束方法,比单独记忆公式更有助于解决实际问题。
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!